
Många har provat ChatGPT eller Claude och blivit imponerade av hur bra en språkmodell kan resonera och formulera svar. Men så fort frågan handlar om er egen verksamhet, era leverantörer, era avtal eller er interna data, stöter man snabbt på en vägg: modellen vet helt enkelt inget om det. Den är tränad på allmän information från internet, inte på er organisations data.
Det är här många företag inser att en ren språkmodell (LLM) inte räcker. För att kunna ge relevanta svar utifrån verksamhetens egen information behöver modellen kopplas till rätt datakällor. Samtidigt behöver informationen hanteras på ett säkert sätt som uppfyller organisationens krav på dataskydd och informationssäkerhet, utan att känslig data behöver skickas till en extern, publik AI-tjänst.
Varför inte bara använda ChatGPT eller Claude direkt?
För många organisationer, särskilt inom offentlig sektor, finans och andra reglerade branscher, finns det tydliga krav på hur intern information får hanteras och delas. Det kan handla om personuppgifter, avtalsvillkor, prisuppgifter eller annan affärskritisk information som inte får hanteras utanför godkända miljöer. Att använda publika AI-tjänster för den här typen av information är därför inte alltid ett alternativ.
För att kunna dra nytta av AI i den egna verksamheten behövs en lösning där språkmodellen kan resonera kring organisationens data, utan att informationen behöver skickas till en extern, publik tjänst och där det samtidigt finns kontroll över hur och var informationen behandlas.
Hur funkar det – RAG och embeddings på ett enkelt sätt
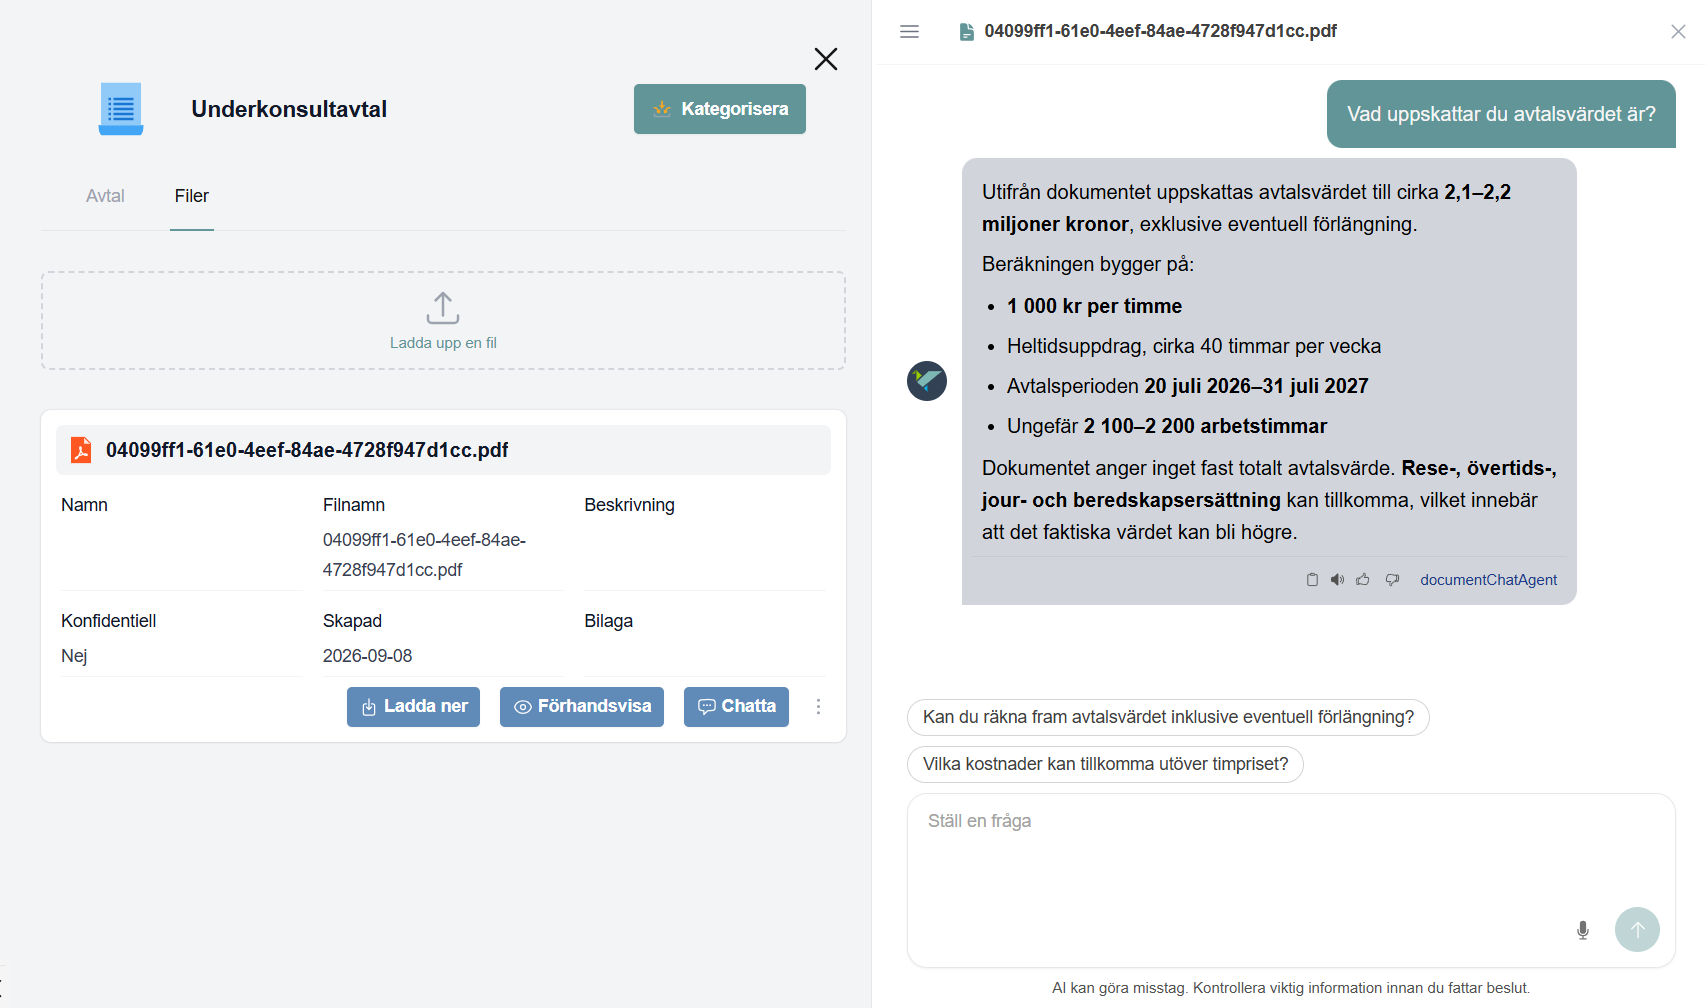
En teknik som gör det möjligt att koppla språkmodeller till verksamhetens egen information är RAG (Retrieval-Augmented Generation). RAG innebär att systemet först söker fram relevant information från organisationens egna datakällor. Informationen används sedan som underlag när språkmodellen formulerar sitt svar. På så sätt kan svaren baseras på innehållet i exempelvis avtal och dokument, i stället för enbart på språkmodellens tidigare träningsdata. Det minskar risken för felaktiga eller påhittade svar, även om det fortfarande är viktigt att kunna kontrollera informationens riktighet.
För att hitta relevant information i stora mängder dokument används bland annat embeddings. Det innebär att text omvandlas till numeriska representationer som fångar innehållets betydelse. Det gör det möjligt att söka utifrån sammanhang och betydelse, snarare än enbart exakta sökord. Om en användare exempelvis frågar vilka avtal organisationen har med leverantörer inom IT-drift kan systemet hitta relevanta dokument även om de innehåller andra begrepp, som supportavtal, hosting eller specifika leverantörsnamn. I praktiken skapas embeddings av dokumentens innehåll och lagras i en vektordatabas. När användaren ställer en fråga söker systemet fram de mest relevanta delarna av dokumenten, som sedan används av språkmodellen för att formulera ett svar.
Hur säkerställer vi en trygg hantering av data i PRO(a)ACT?
Poängen med hela upplägget är att ingen data behöver lämna er miljö. Genom att köra både embeddings-databasen och språkmodellen inom er egen miljö i PRO(a)ACT kan ni få samma typ av konversationsbaserad upplevelse som ChatGPT eller Claude, men helt inom ramarna för er egen datahantering och era säkerhetskrav.
Det innebär att användarna kan ställa frågor om sina dokument och få hjälp att hitta och sammanställa relevant information, samtidigt som organisationen behåller kontrollen över hur och var informationen behandlas.


